Hành trình lột xác cách ứng dụng phần mềm tương tác với dữ liệu
Sự bùng nổ của các mô hình ngôn ngữ lớn đã thay đổi hoàn toàn cách chúng ta định nghĩa về một phần mềm thông minh. Thay vì những câu lệnh điều kiện khô khan hay các giao diện người dùng cứng nhắc, thế hệ ứng dụng hiện đại đòi hỏi khả năng tự chủ cao hơn rất nhiều. Trí tuệ nhân tạo không chỉ dừng lại ở việc phản hồi một câu hỏi ngẫu nhiên mà còn phải biết lập kế hoạch, gọi các dịch vụ bên ngoài, duy trì trạng thái hội thoại và tự đưa ra quyết định để giải quyết trọn vẹn một bài toán phức tạp.
Đối với cộng đồng lập trình viên chuyên sử dụng nền tảng JavaScript, việc nắm bắt xu hướng này đòi hỏi một nền tảng chuyên môn vững chắc. Khi các thư viện tự động hóa cao cấp che giấu đi quá nhiều chi tiết bên dưới, việc hiểu rõ bản chất của từng lời gọi hàm và cách quản lý luồng dữ liệu trở thành yếu tố sống còn. Để thiết kế một hệ thống thực sự ổn định, bạn cần đi từ gốc rễ thay vì chỉ phụ thuộc vào những lớp vỏ bọc trừu tượng do các công cụ bên ngoài cung cấp.
Việc làm chủ công nghệ mới luôn bắt đầu từ việc thấu hiểu các nguyên lý cốt lõi. Khi xây dựng một nền tảng vững chắc, việc theo đuổi lộ trình Backend NodeJS Developer sẽ giúp bạn dễ dàng tích hợp các hệ thống xử lý thông minh vào trong kiến trúc phần mềm sẵn có của doanh nghiệp mà không gặp phải bất kỳ rào cản nào về hiệu năng hay khả năng mở rộng.
Bản chất của lời gọi hàm và công cụ trong lập trình mô hình ngôn ngữ
Mô hình ngôn ngữ bản chất chỉ là một bộ máy dự đoán từ tiếp theo dựa trên xác suất thống kê. Để biến nó thành một thực thể có ích trong thế giới thực, chúng ta cần cung cấp cho nó khả năng gọi các công cụ bên ngoài thông qua cơ chế có cấu trúc rõ ràng. Thay vì để hệ thống tự sinh ra văn bản tự do, tính năng định nghĩa hàm cho phép chúng ta ép buộc mô hình trả về dữ liệu dưới dạng JSON hợp lệ để thực thi các tác vụ thực tế.
Quá trình này diễn ra qua nhiều bước tuần tự nhưng cực kỳ nhanh chóng. Đầu tiên, ứng dụng gửi kèm danh sách các công cụ khả dụng cùng với định nghĩa tường minh về tham số đầu vào. Khi người dùng đặt câu hỏi, mô hình sẽ phân tích xem có cần gọi công cụ nào hay không và trả về tên hàm cùng các tham số cần thiết. Nhiệm vụ của mã nguồn phía máy chủ là bắt lấy tín hiệu đó, thực thi hàm thực tế trong cơ sở hạ tầng của mình và gửi kết quả trả ngược lại cho mô hình để tiếp tục quá trình suy luận.
Việc nắm bắt cơ chế này giúp lập trình viên kiểm soát hoàn toàn dòng tiền và chi phí gọi API. Tránh tình trạng để hệ thống lặp vô tận hoặc gọi nhầm những công cụ nhạy cảm gây tổn hại đến dữ liệu người dùng. Sự minh bạch trong từng dòng mã nguồn thuần giúp chúng ta dễ dàng viết kiểm thử và cô lập lỗi khi có sự cố phát sinh trong quá trình vận hành.
Thiết lập cấu trúc giao tiếp trực tiếp với OpenAI SDK
Việc sử dụng trực tiếp thư viện chính thức giúp loại bỏ những lớp trung gian gây chậm trễ và khó debug. Dưới đây là đoạn mã thực tế minh họa cách khởi tạo một vòng lặp xử lý công cụ cơ bản bằng JavaScript, nơi ứng dụng chủ động điều phối dữ liệu giữa người dùng và các dịch vụ bên ngoài.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
});

async function executeAgentLoop(userPrompt) {
  const messages = [{ role: "user", content: userPrompt }];
  const tools = [
    {
      type: "function",
      function: {
        name: "getSystemMetrics",
        description: "Lấy thông tin hiệu năng hệ thống hiện tại",
        parameters: {
          type: "object",
          properties: {
            metricType: {
              type: "string",
              enum: ["cpu", "memory", "disk"],
              description: "Loại thông số cần kiểm tra",
            },
          },
          required: ["metricType"],
        },
      },
    },
  ];

  let response = await client.chat.completions.create({
    model: "gpt-4o",
    messages: messages,
    tools: tools,
    tool_choice: "auto",
  });

  const responseMessage = response.choices[0].message;

  if (responseMessage.tool_calls) {
    for (const toolCall of responseMessage.tool_calls) {
      if (toolCall.function.name === "getSystemMetrics") {
        const args = JSON.parse(toolCall.function.arguments);
        console.log(`Đang thực thi lấy dữ liệu cho: ${args.metricType}`);
      }
    }
  }
}
Đoạn mã trên thể hiện rõ ràng cách thiết lập một vòng lặp tương tác cơ bản mà không cần dựa vào bất kỳ framework phức tạp nào. Bằng cách định nghĩa rõ cấu trúc dữ liệu đầu vào và đầu ra, ứng dụng có thể dịch chuyển mượt mà giữa ngôn ngữ tự nhiên của con người và các câu lệnh thực thi bằng mã nguồn.
Xây dựng cơ sở tri thức riêng biệt với kiến trúc RAG
Mô hình ngôn ngữ thông thường chỉ sở hữu lượng kiến thức được huấn luyện từ trước và hoàn toàn mù tịt về dữ liệu nội bộ của doanh nghiệp. Để giải quyết bài toán này, kỹ thuật tăng cường tri thức bằng dữ liệu bên ngoài trở thành tiêu chuẩn vàng trong các hệ thống phần mềm hiện đại. Thay vì cố gắng nhồi nhét mọi tài liệu vào trong ngữ cảnh, chúng ta sử dụng cơ sở dữ liệu véc tơ để tra cứu chính xác những đoạn thông tin liên quan nhất.
Quá trình này đòi hỏi một đường ống xử lý dữ liệu đầu vào vô cùng nghiêm ngặt. Tài liệu gốc phải được cắt nhỏ thành các phân đoạn có kích thước hợp lý, sau đó được chuyển đổi thành các chuỗi số thực biểu diễn ngữ nghĩa thông qua mô hình nhúng. Khi người dùng đưa ra yêu cầu, hệ thống sẽ tính toán độ tương đồng giữa câu hỏi và kho lưu trữ véc tơ để chọn ra những ngữ cảnh chính xác nhất trước khi gửi kèm vào lời gọi đến mô hình chính.
Việc lựa chọn chiến lược phân đoạn tài liệu đóng vai trò quyết định đến độ chính xác của toàn bộ hệ thống. Nếu đoạn văn quá ngắn, ngữ cảnh sẽ bị rời rạc và thiếu chiều sâu. Ngược lại, nếu đoạn văn quá dài, mô hình sẽ bị loãng thông tin và dễ bỏ qua những chi tiết quan trọng ẩn giấu bên trong dữ liệu gốc.
Tối ưu hóa chiến lược lưu trữ và truy vấn véc tơ
Hiệu năng của hệ thống tra cứu tri thức phụ thuộc rất lớn vào cách tổ chức chỉ mục trong cơ sở dữ liệu chuyên dụng. Việc lưu trữ hàng triệu véc tơ đòi hỏi các thuật toán tìm kiếm xấp xỉ không gian cao để đảm bảo thời gian phản hồi luôn ở mức mili giây, đáp ứng tốt nhu cầu tương tác thời gian thực của người dùng cuối.
Khi thiết kế tầng dữ liệu này, lập trình viên cần cân nhắc kỹ lưỡng giữa độ chính xác tuyệt đối và tốc độ xử lý. Các cấu trúc chỉ mục dựa trên đồ thị phân cấp thường mang lại hiệu suất vượt trội nhưng đòi hỏi lượng bộ nhớ lớn để duy trì các liên kết không gian. Việc lựa chọn công nghệ lưu trữ phù hợp với quy mô thực tế của doanh nghiệp sẽ giúp tiết kiệm đáng kể chi phí hạ tầng.
Bên cạnh đó, việc làm sạch dữ liệu trước khi đưa vào quá trình nhúng là bước không thể bỏ qua. Loại bỏ các ký tự rác, chuẩn hóa định dạng văn bản và bổ sung siêu dữ liệu giúp tăng cường độ chính xác cho mỗi lần tra cứu, từ đó giúp hệ thống đưa ra câu trả lời sắc sảo và đáng tin cậy hơn.
Xử lý dòng dữ liệu lớn với mã nguồn bất đồng bộ
Việc kết nối các thành phần tra cứu tri thức với mô hình ngôn ngữ đòi hỏi một hệ thống xử lý bất đồng bộ mượt mà để tránh nghẽn cổ chai trong quá trình truyền tải dữ liệu. Dưới đây là đoạn mã minh họa cách xử lý luồng phản hồi trực tuyến bằng JavaScript để cải thiện trải nghiệm người dùng.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
});

async function streamAssistantResponse(messages, onChunkReceived) {
  try {
    const stream = await client.chat.completions.create({
      model: "gpt-4o",
      messages: messages,
      stream: true,
    });

    for await (const chunk of stream) {
      const content = chunk.choices[0]?.delta?.content || "";
      if (content) {
        onChunkReceived(content);
      }
    }
  } catch (error {
    console.error("Lỗi trong quá trình truyền tải dữ liệu:", error.message);
    throw error;
  }
}
Sử dụng cơ chế truyền tải trực tuyến giúp giảm thiểu độ trễ cảm nhận từ phía người dùng cuối. Thay vì phải chờ đợi toàn bộ câu trả lời được sinh ra xong mới hiển thị, giao diện có thể cập nhật từng từ theo thời gian thực, mang lại trải nghiệm tương tự như các ứng dụng trò chuyện cao cấp trên thị trường.
Quản lý bộ nhớ và duy trì trạng thái ngữ cảnh
Trạng thái hội thoại là linh hồn của bất kỳ hệ thống tương tác thông minh nào. Một mô hình ngôn ngữ bản chất không hề có trí nhớ dài hạn và luôn hoạt động theo nguyên lý không trạng thái trong từng lần gọi API. Do đó, việc duy trì lịch sử hội thoại hoàn toàn nằm trong trách nhiệm của mã nguồn ứng dụng phía backend.
Việc lưu trữ toàn bộ lịch sử trò chuyện vào bộ nhớ ngắn hạn nhanh chóng trở thành thảm họa khi phiên làm việc kéo dài quá lâu, dẫn đến việc vượt quá giới hạn số lượng token cho phép của mô hình. Giải pháp cho vấn đề này là thiết kế một cơ chế tóm tắt định kỳ kết hợp với bộ nhớ dài hạn được lưu trữ trong cơ sở dữ liệu quan hệ hoặc kho chứa khóa giá trị tốc độ cao.
Hệ thống cần phân biệt rõ ràng giữa bộ nhớ ngắn hạn phục vụ cho ngữ cảnh tức thời và bộ nhớ dài hạn lưu trữ các thông tin cốt lõi về người dùng. Điều này giúp hệ thống vừa duy trì được sự liền mạch trong cuộc trò chuyện hiện tại, vừa ghi nhớ được các sở thích lâu dài để cá nhân hóa trải nghiệm ở những lần truy cập tiếp theo.
Thiết kế cấu trúc lưu trữ lịch sử hội thoại tối ưu
Việc lựa chọn mô hình lưu trữ cho lịch sử hội thoại quyết định tốc độ phản hồi của toàn bộ hệ thống khi số lượng người dùng đồng thời tăng cao. Các cơ sở dữ liệu lưu trữ tài liệu linh hoạt hoặc kho chứa khóa giá trị thường là lựa chọn hàng đầu nhờ khả năng đọc ghi nhanh chóng và cấu trúc dữ liệu phù hợp với định dạng JSON của tin nhắn.
Bên cạnh đó, việc áp dụng chiến lược phân tầng dữ liệu giúp giảm tải đáng kể cho hệ thống chính. Những cuộc trò chuyện cũ không còn hoạt động thường xuyên có thể được chuyển sang các kho lưu trữ lạnh với chi phí thấp hơn, trong khi các phiên làm việc đang diễn ra được duy trì hoàn toàn trong bộ nhớ đệm tốc độ cao.
Để củng cố thêm kiến thức toàn diện về các câu hỏi thường gặp khi phỏng vấn hoặc thiết kế kiến trúc hệ thống thông minh, bạn có thể tham khảo thêm sách Tổng hợp câu hỏi phỏng vấn AI Agent & Kiến trúc Agentic nhằm nắm bắt trọn vẹn các góc nhìn từ chuyên gia hàng đầu trong ngành.
Quản lý giới hạn token và cắt tỉa lịch sử thông minh
Quản lý tài nguyên token là bài toán kinh tế trực tiếp đối với bất kỳ doanh nghiệp nào vận hành dịch vụ thông minh trên quy mô lớn. Việc gửi quá nhiều dữ liệu thừa thãi trong mỗi lần gọi API không chỉ làm tăng chi phí vận hành mà còn làm giảm độ chính xác của mô hình khi phải xử lý quá nhiều nhiễu thông tin.
Dưới đây là đoạn mã thực tế minh họa cách tự động cắt tỉa lịch sử hội thoại để giữ lại các tin nhắn quan trọng nhất trước khi gửi yêu cầu đến máy chủ từ xa.
function sanitizeConversationHistory(messages, maxTokenLimit = 4000) {
  let estimatedTokens = 0;
  const sanitizedMessages = [];

  const systemPrompt = messages.find(m => m.role === "system");
  if (systemPrompt) {
    sanitizedMessages.push(systemPrompt);
    estimatedTokens += systemPrompt.content.length / 4;
  }

  const nonSystemMessages = messages.filter(m => m.role !== "system");

  for (let i = nonSystemMessages.length - 1; i >= 0; i--) {
    const message = nonSystemMessages[i];
    const messageTokens = message.content.length / 4;

    if (estimatedTokens + messageTokens > maxTokenLimit) {
      break;
    }

    sanitizedMessages.unshift(message);
    estimatedTokens += messageTokens;
  }

  return sanitizedMessages;
}
Thuật toán trên ưu tiên giữ lại các tin nhắn gần nhất và luôn bảo toàn chỉ thị hệ thống ban đầu để đảm bảo tính cách và quy tắc ứng xử của trợ lý không bị thay đổi trong suốt quá trình trò chuyện kéo dài.
Triển khai kiến trúc nhiều tác nhân phối hợp
Khi các tác vụ trở nên quá phức tạp đối với một thực thể đơn lẻ, việc chia nhỏ công việc cho nhiều chuyên gia ảo phối hợp với nhau là hướng đi tất yếu của kiến trúc phần mềm hiện đại. Thay vì dồn mọi trách nhiệm cho một mô hình duy nhất, hệ thống nhiều tác nhân phân chia rõ ràng vai trò của từng thành phần như phân tích yêu cầu, viết mã nguồn, kiểm tra lỗi và tổng hợp kết quả.
Mô hình điều phối trung tâm đóng vai trò như một người quản lý dự án thực thụ. Thành phần này nhận yêu cầu từ người dùng, phân tách thành các nhiệm vụ nhỏ hơn và phân công cho các tác nhân chuyên biệt thực hiện tuần tự hoặc song song. Quá trình trao đổi thông tin giữa các tác nhân diễn ra hoàn toàn tự động thông qua các giao thức truyền thông điệp có cấu trúc.
Cách tiếp cận này không chỉ nâng cao độ chính xác trong việc giải quyết các bài toán lớn mà còn giúp dễ dàng mở rộng tính năng khi cần thiết. Thay vì phải huấn luyện lại toàn bộ hệ thống, chúng ta chỉ cần bổ sung thêm một tác nhân mới với các công cụ chuyên dụng hoàn toàn độc lập với phần còn lại của ứng dụng.
Cơ chế điều phối và giao tiếp giữa các tác nhân
Sự thành công của một hệ thống nhiều tác nhân phụ thuộc hoàn toàn vào cách chúng chia sẻ ngữ cảnh và bàn giao công việc cho nhau. Nếu không có một quy luật rõ ràng, các tác nhân rất dễ rơi vào vòng lặp tranh chấp hoặc đưa ra những kết quả mâu thuẫn lẫn nhau.
Việc thiết kế một tầng giao tiếp chuẩn hóa giúp mọi thành phần trong hệ thống hiểu rõ trạng thái hiện tại của toàn bộ dự án. Mỗi tác nhân khi hoàn thành nhiệm vụ của mình phải đính kèm các báo cáo chi tiết cùng với dữ liệu đầu ra để tác nhân tiếp theo có thể tiếp nhận và xử lý mà không gặp phải bất kỳ sự gián đoạn nào.
Bên cạnh đó, việc áp dụng các cơ chế kiểm tra chéo giữa các tác nhân giúp phát hiện sớm những sai sót trong quá trình thực thi. Ví dụ tác nhân lập trình viết xong mã nguồn sẽ chuyển ngay cho tác nhân kiểm thử phân tích bảo mật trước khi cho phép hệ thống triển khai vào môi trường thực tế.
Đảm bảo an toàn và phòng chống rủi ro bảo mật
Đưa một hệ thống thông minh vào môi trường vận hành thực tế đồng nghĩa với việc đối mặt với vô số thách thức mới về bảo mật mà các ứng dụng truyền thống chưa từng gặp phải. Kỹ thuật tiêm nhiễm câu lệnh độc hại qua đầu vào của người dùng có thể khiến hệ thống vượt qua mọi giới hạn kiểm soát và thực thi những hành động nguy hiểm trên máy chủ.
Mỗi công cụ mà tác nhân có quyền truy cập đều phải được giới hạn quyền hạn một cách nghiêm ngặt theo nguyên tắc đặc quyền tối thiểu. Một hàm dùng để truy vấn cơ sở dữ liệu tuyệt đối không được phép có khả năng thực thi câu lệnh xóa bảng hay thay đổi cấu trúc hệ thống nếu không có sự phê duyệt trực tiếp từ người quản trị.
Việc kiểm soát chặt chẽ các đầu vào và đầu ra giúp ngăn chặn tình trạng rò rỉ thông tin nhạy cảm qua các lời gọi hàm bên ngoài. Các lớp lọc dữ liệu tự động cần được tích hợp ngay tại tầng trung gian để kiểm tra nội dung trước khi gửi đi hoặc trước khi hiển thị cho người dùng cuối.
Xây dựng tường lửa bảo vệ và kiểm soát quyền hạn công cụ
Bảo mật cho ứng dụng tích hợp mô hình ngôn ngữ đòi hỏi một tư duy phòng thủ nhiều lớp hoàn toàn khác biệt so với các phương pháp kiểm tra tính hợp lệ truyền thống. Do đầu vào từ người dùng luôn mang tính tự do và khó đoán trước, việc áp dụng các bộ lọc ngữ nghĩa kết hợp với kiểm tra quy tắc cứng là điều kiện tiên quyết.
Mỗi khi một tác nhân yêu cầu thực thi một công cụ quan trọng, hệ thống cần kích hoạt cơ chế xác thực bổ sung để đảm bảo yêu cầu đó xuất phát từ một ngữ cảnh hợp lệ và không chứa các dấu hiệu gian lận. Điều này giúp ngăn chặn tuyệt đối các hành vi lạm dụng quyền hạn hệ thống từ những kẻ tấn công cố tình tìm cách thao túng mô hình.
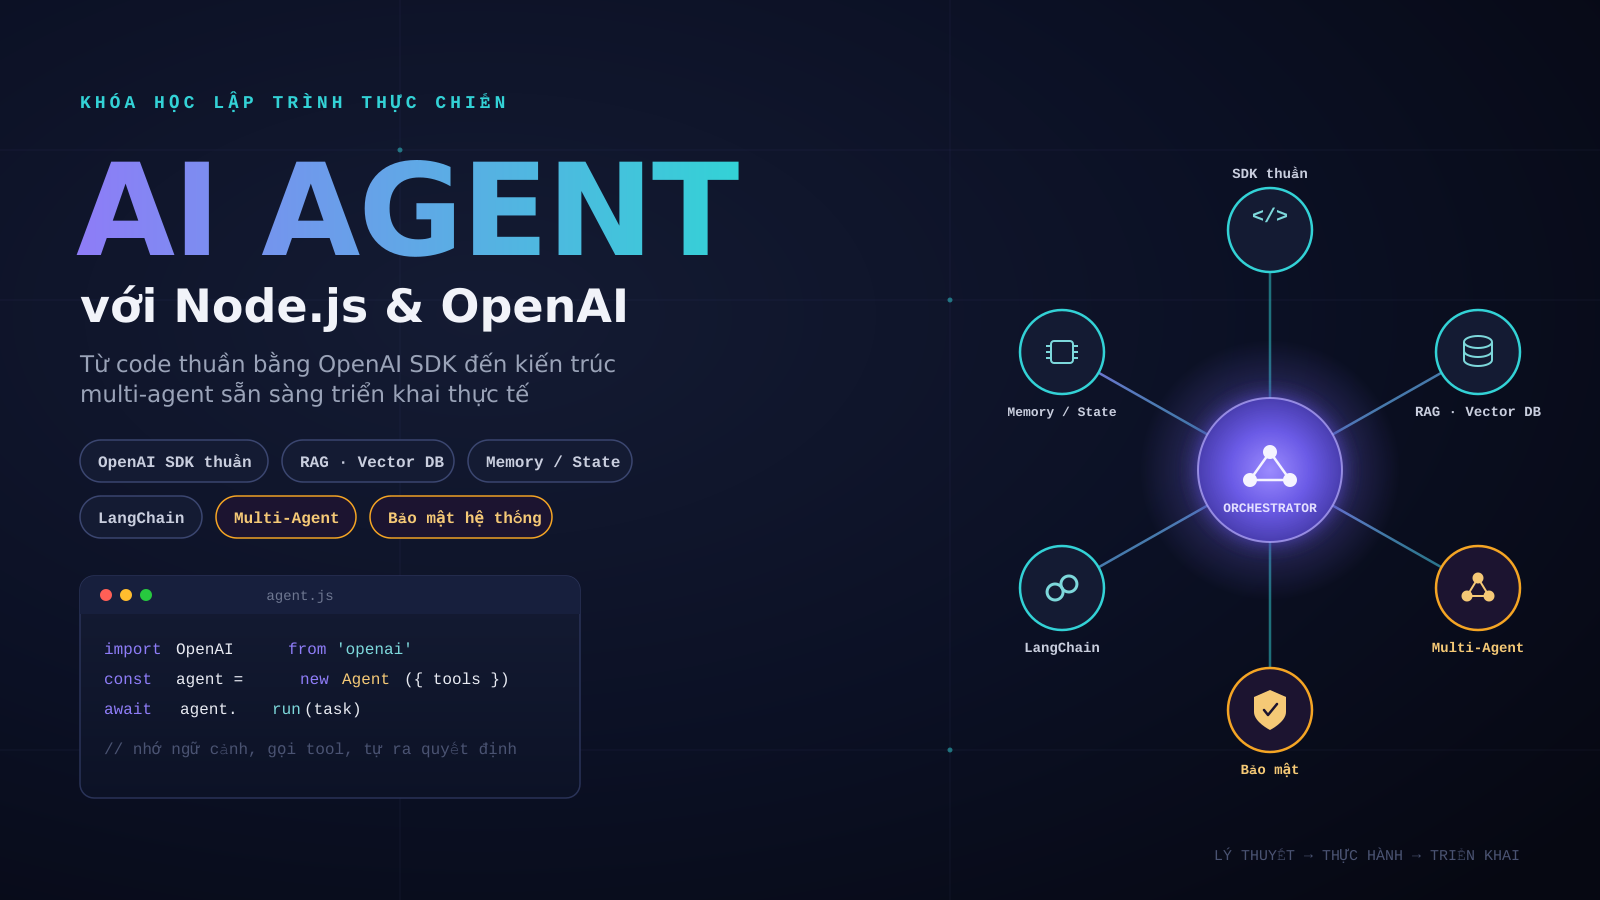
Nếu bạn muốn làm chủ trọn vẹn kiến thức chuyên sâu này và tự tay xây dựng những ứng dụng thông minh sẵn sàng đưa vào môi trường sản xuất thực tế, hãy tham khảo ngay khóa học Lập trình AI Agent với NodeJS & OpenAI tại Unicode Academy để nâng tầm kỹ năng lập trình của bạn lên một mức cao mới.






Bình luận 0
Chia sẻ ý kiến hoặc đặt câu hỏi cùng cộng đồng