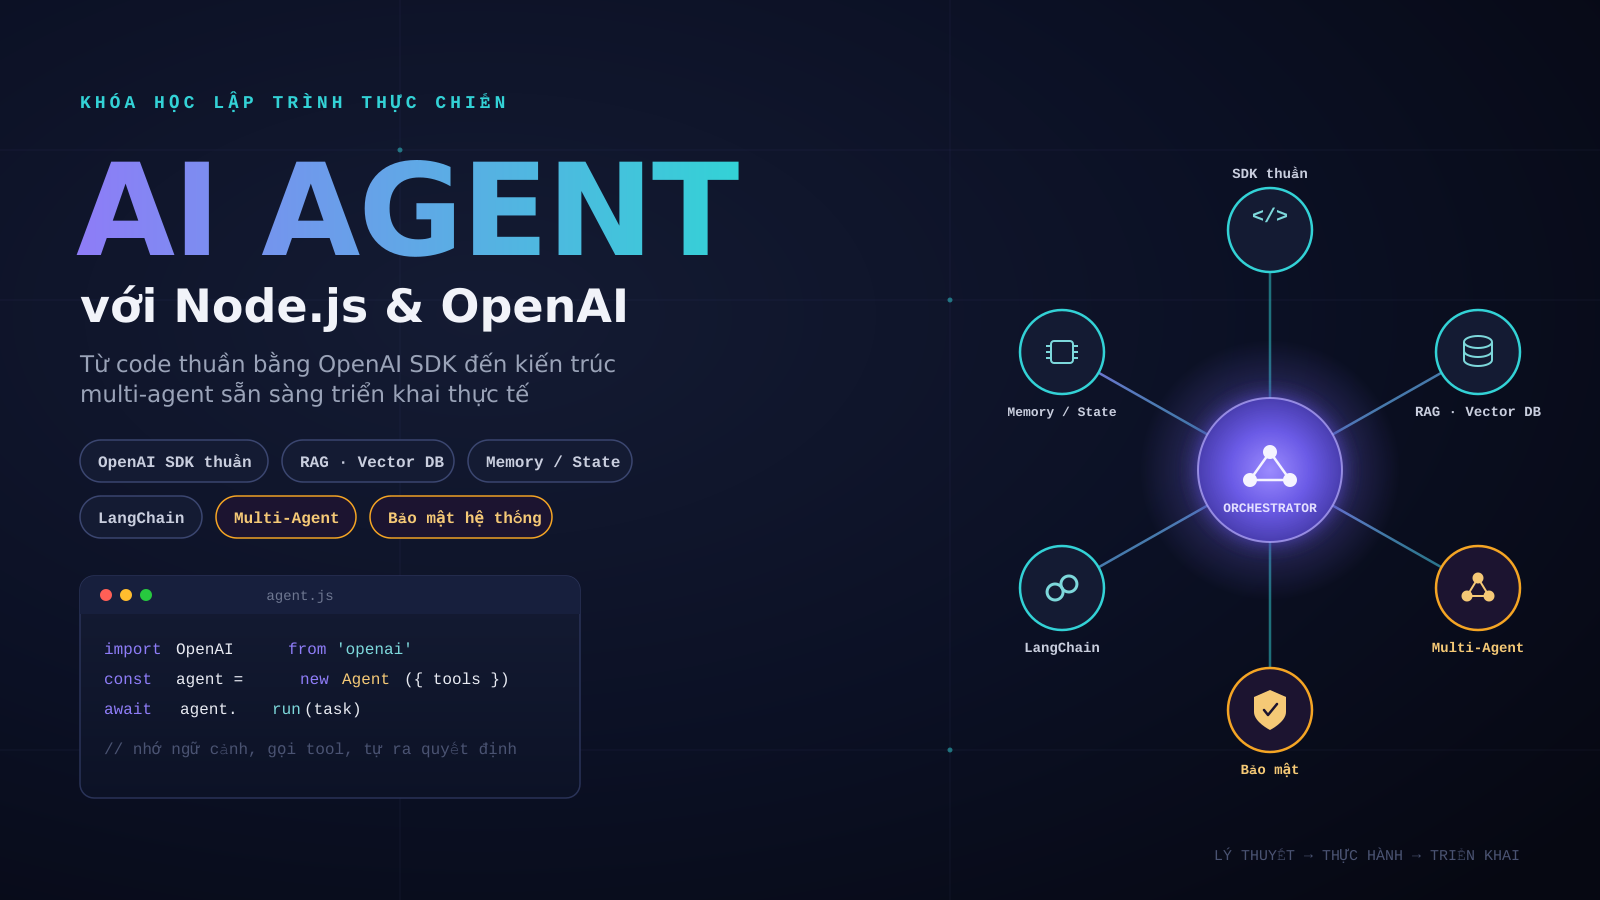
- Giải mã kiến trúc cốt lõi của hệ thống AI Agent hiện đại
- Tích hợp cơ sở dữ liệu vector và chiến lược tìm kiếm ngữ nghĩa
- Thiết kế hệ thống quản lý bộ nhớ và trạng thái xuyên phiên
- Kiến trúc phối hợp hệ thống nhiều tác nhân chuyên biệt
- Bảo mật hệ thống và chiến lược phòng chống tấn công
- Vận hành hệ thống và tối ưu hóa hiệu năng trên môi trường thực tế
Giải mã kiến trúc cốt lõi của hệ thống AI Agent hiện đại
Sự chuyển dịch từ các mô hình chatbot hỏi đáp truyền thống sang các thực thể tự động hóa đánh dấu một bước ngoặt lớn trong tư duy thiết kế phần mềm. Thay vì chỉ nhận câu hỏi và trả về kết quả ngay lập tức thông qua một vòng lặp đơn giản, một agent thông minh đòi hỏi một vòng đời xử lý phức tạp hơn rất nhiều. Hệ thống phải liên tục đánh giá trạng thái hiện tại, tự quyết định bước đi tiếp theo, gọi các công cụ ngoại vi và kiểm soát bộ nhớ ngữ cảnh qua từng vòng lặp suy luận.
Việc nắm vững cách vận hành của các mô hình ngôn ngữ lớn từ tầng thấp nhất giúp lập trình viên kiểm soát hoàn toàn hành vi của ứng dụng mà không bị phụ thuộc vào các framework cồng kềnh. Khi xây dựng các hệ thống quy mô lớn, việc hiểu rõ bản chất của quá trình giao tiếp qua mạng với máy chủ cung cấp dịch vụ trí tuệ nhân tạo là chìa khóa để tối ưu hóa độ trễ và chi phí vận hành. Điều này tương tự như việc quản lý tài nguyên hệ thống trong các bài toán hạ tầng, nơi bạn cần am hiểu sâu sắc cách các tiến trình giao tiếp với nhau như khi nghiên cứu kiến thức từ kiến thức Làm chủ khóa học devops với Docker: Xây dựng hệ thống container trên nền tảng.
Một hệ thống tự động hóa hoàn chỉnh thường bao gồm một bộ điều phối trung tâm chịu trách nhiệm phân tích ý định của người dùng, lựa chọn công cụ phù hợp từ danh sách các hàm có sẵn và xử lý kết quả trả về từ công cụ đó. Vòng lặp này tiếp tục diễn ra cho đến khi tác vụ được hoàn thành hoặc đạt đến giới hạn số bước lặp cho phép để tránh việc hệ thống bị rơi vào vòng lặp vô hạn gây tiêu tốn tài nguyên.
Vòng lặp suy luận và hành động trong kiến trúc Agent
Vòng lặp suy luận đóng vai trò là bộ não điều phối toàn bộ hoạt động của ứng dụng, nơi các quyết định được đưa ra dựa trên ngữ cảnh hiện tại và dữ liệu lịch sử. Cơ chế này hoạt động theo mô hình từng bước một, trong đó mô hình ngôn ngữ phân tích yêu cầu, xác định xem có cần sự can thiệp của các công cụ bên ngoài hay không và tạo ra các tham số cần thiết cho lệnh gọi tiếp theo.
Khi lập trình viên tương tác với các giao diện lập trình ứng dụng thông qua mã nguồn, việc quản lý mảng tin nhắn lịch sử đóng vai trò quyết định đến độ chính xác của phản hồi. Mỗi lần công cụ trả về kết quả, dữ liệu đó phải được đưa ngược trở lại vào danh sách ngữ cảnh dưới dạng một thông điệp phản hồi từ công cụ để mô hình có thể đọc và tiếp tục quá trình tư duy.
Sự minh bạch trong luồng dữ liệu này giúp đội ngũ phát triển dễ dàng gỡ lỗi các tình huống agent đưa ra quyết định sai lầm hoặc gọi sai tham số. Việc kiểm soát từng thông điệp gửi đi và nhận về giúp loại bỏ hoàn toàn hộp đen thường gặp khi sử dụng các công cụ tự động hóa cấp cao.
Cơ chế định nghĩa và gọi công cụ
Định nghĩa công cụ là bước cấu hình các hàm có thể được kích hoạt bởi mô hình ngôn ngữ lớn thông qua cấu trúc dữ liệu chuẩn hóa. Các định nghĩa này cung cấp tên hàm, mô tả chi tiết về chức năng và lược đồ tham số đầu vào để mô hình hiểu rõ khi nào và cách thức sử dụng chúng một cách chính xác nhất.
Khi mô hình nhận thấy một yêu cầu cần sử dụng dữ liệu thực tế từ hệ thống bên ngoài, thay vì trả về văn bản thông thường, nó sẽ trả về một cấu trúc yêu cầu gọi hàm kèm theo các đối số đã được trích xuất từ câu hỏi của người dùng. Backend sẽ nhận cấu trúc này, thực thi đoạn mã tương ứng trong môi trường thực tế và lấy kết quả trả về.
Việc xác thực dữ liệu đầu vào cho các hàm này là cực kỳ quan trọng để đảm bảo tính an toàn cho hệ thống trước khi chuyển tiếp kết quả cho các tầng xử lý tiếp theo. Bất kỳ lỗi nào phát sinh trong quá trình thực thi công cụ đều cần được bắt giữ và gửi lại phản hồi lỗi cho mô hình để nó tự động điều chỉnh cách tiếp cận.
Xây dựng mã nguồn khởi tạo vòng lặp với OpenAI SDK thuần
Đoạn mã dưới đây minh họa cách thiết lập một vòng lặp xử lý cơ bản bằng thư viện chính thức của nhà cung cấp, cho phép agent tự động gọi hàm khi cần thiết mà không thông qua bất kỳ framework trung gian nào.
const OpenAI = require('openai');
const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

async function runAgent(userPrompt) {
  const messages = [{ role: 'user', content: userPrompt }];
  const tools = [
    {
      type: 'function',
      function: {
        name: 'get_current_weather',
        description: 'Lấy thông tin thời tiết hiện tại cho một thành phố cụ thể',
        parameters: {
          type: 'object',
          properties: {
            location: { type: 'string', name: 'Tên thành phố' }
          },
          required: ['location']
        }
      }
    }
  ];

  let continueLoop = true;
  while (continueLoop) {
    try {
      const response = await client.chat.completions.create({
        model: 'gpt-4o',
        messages: messages,
        tools: tools,
        tool_choice: 'auto'
      });

      const responseMessage = response.choices[0].message;
      messages.push(responseMessage);

      if (!responseMessage.tool_calls) {
        continueLoop = false;
        return responseMessage.content;
      }

      for (const toolCall of responseMessage.tool_calls) {
        const functionName = toolCall.function.name;
        const functionArgs = JSON.parse(toolCall.function.arguments);

        let toolResult = '';
        if (functionName === 'get_current_weather') {
          toolResult = JSON.stringify({ temperature: '28 độ C', condition: 'Nắng nhẹ' });
        }

        messages.push({
          tool_call_id: toolCall.id,
          role: 'tool',
          name: functionName,
          content: toolResult
        });
      }
    } catch (error) {
      console.error('Lỗi trong quá trình thực thi agent:', error);
      throw error;
    }
  }
}
Đoạn mã trên thể hiện rõ bản chất của một vòng lặp tương tác hai chiều giữa mã nguồn và mô hình ngôn ngữ lớn. Thông qua việc kiểm tra thuộc tính phản hồi từ kết quả trả về, hệ thống biết chính xác khi nào cần thực thi hành động ngoại vi và khi nào cần kết thúc phiên làm việc để trả kết quả cuối cùng về cho người dùng.
Tích hợp cơ sở dữ liệu vector và chiến lược tìm kiếm ngữ nghĩa
Khả năng tiếp cận thông tin chuyên ngành và dữ liệu nội bộ của doanh nghiệp là yếu tố phân định giữa một hệ thống thông thường và một trợ lý ảo thực sự hữu ích. Việc đưa dữ liệu thô trực tiếp vào bộ nhớ tạm thời của mô hình gặp giới hạn nghiêm ngặt về dung lượng, đồng thời làm tăng chi phí tính toán cho mỗi lần yêu cầu.
Giải pháp tối ưu cho bài toán này là kết hợp cơ sở dữ liệu vector với kỹ thuật tìm kiếm tương đồng dựa trên khoảng cách không gian nhiều chiều. Dữ liệu văn bản được chuyển đổi thành các mảng số thực thông qua các mô hình nhúng chuyên dụng, sau đó được lưu trữ và truy vấn cực kỳ nhanh chóng khi có yêu cầu từ người dùng.
Quá trình này đòi hỏi một đường ống xử lý dữ liệu đầu vào bao gồm việc cắt nhỏ văn bản thành các đoạn có kích thước phù hợp, chuyển đổi thành vector và lưu trữ kèm theo các siêu dữ liệu cần thiết để phục vụ cho việc lọc dữ liệu sau này.
Chiến lược phân đoạn văn bản và tối ưu kích thước
Phân đoạn văn bản là bước đầu tiên và quan trọng nhất trong việc xây dựng hệ thống tìm kiếm ngữ nghĩa, quyết định trực tiếp đến độ chính xác của thông tin được trích xuất. Nếu kích thước đoạn quá lớn, thông tin chi tiết sẽ bị loãng và làm giảm độ tương đồng khi tính toán khoảng cách vector. Ngược lại, nếu đoạn quá nhỏ, ngữ cảnh quan trọng xung quanh có thể bị cắt đứt khiến ý nghĩa của câu bị thay đổi hoàn toàn.
Các chiến lược cắt đoạn hiện đại thường dựa trên cấu trúc ngữ nghĩa của tài liệu thay vì chỉ đơn thuần đếm số lượng ký tự hay số từ. Việc chia tách theo các tiêu đề, đoạn văn hoặc sử dụng các bộ tách có ý thức về cấu trúc giúp bảo toàn trọn vẹn thông tin cốt lõi của tài liệu gốc.
Sau khi phân đoạn, mỗi phần văn bản sẽ đi qua mô hình tạo vector để chuyển đổi thành các tọa độ số học trong không gian nhiều chiều. Các tọa độ này phản ánh bản chất ngữ nghĩa của nội dung, cho phép hệ thống tìm ra các đoạn văn có ý nghĩa tương đồng ngay cả khi không sử dụng chung một từ khóa.
Xây dựng hệ thống tìm kiếm tương đồng trong Node.js
Đoạn mã dưới đây minh họa quy trình tạo vector cho một truy vấn mới và thực hiện tìm kiếm trên cơ sở dữ liệu để trích xuất các tài liệu có độ liên quan cao nhất.
const OpenAI = require('openai');
const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

async function getEmbedding(text) {
  const response = await client.embeddings.create({
    model: 'text-embedding-3-small',
    input: text,
    encoding_format: 'float'
  });
  return response.data[0].embedding;
}

async function searchKnowledgeBase(userQuery, vectorDatabaseClient) {
  try {
    const queryEmbedding = await getEmbedding(userQuery);

    const searchResults = await vectorDatabaseClient.query({
      vector: queryEmbedding,
      topK: 3,
      includeMetadata: true
    });

    const contextChunks = searchResults.matches.map(match => match.metadata.text);
    return contextChunks.join('

');
  } catch (error) {
    console.error('Lỗi khi tìm kiếm cơ sở tri thức:', error);
    return '';
  }
}
Hàm xử lý trên đóng vai trò là cầu nối giữa câu hỏi của người dùng và kho tri thức nội bộ của hệ thống. Bằng cách kết hợp kết quả tìm kiếm vector vào ngữ cảnh gửi đi, agent có thể tự tin đưa ra câu trả lời dựa trên dữ liệu thực tế của doanh nghiệp thay vì chỉ dựa vào kiến thức có sẵn của mô hình.
Thiết kế hệ thống quản lý bộ nhớ và trạng thái xuyên phiên
Duy trì ngữ cảnh trong suốt một phiên làm việc dài là thách thức lớn khi xây dựng các ứng dụng thông minh trên nền tảng web do bản chất không có trạng thái của giao thức giao tiếp. Một hệ thống quản lý bộ nhớ tốt không chỉ lưu lại lịch sử tin nhắn mà còn phải biết cách tóm tắt, nén và loại bỏ những thông tin cũ không còn quan trọng để tiết kiệm không gian ngữ cảnh.
Bộ nhớ ngắn hạn giúp agent nhớ được các trao đổi vừa diễn ra trong vài phút trước đó, trong khi bộ nhớ dài hạn lưu trữ các thông tin cốt lõi về người dùng như sở thích, lịch sử tương tác hoặc các thiết lập cá nhân hóa qua nhiều phiên làm việc khác nhau.
Việc lưu trữ trạng thái này đòi hỏi sự kết hợp chặt chẽ giữa cơ sở dữ liệu quan hệ truyền thống và hệ thống lưu trữ tạm thời tốc độ cao để đảm bảo độ trễ thấp nhất khi người dùng gửi yêu cầu tiếp theo.
Phân tầng bộ nhớ ngắn hạn và dài hạn
Bộ nhớ ngắn hạn hoạt động như một cửa sổ trượt chứa danh sách các tin nhắn gần nhất trong phiên làm việc hiện tại. Khi số lượng tin nhắn vượt quá giới hạn cho phép của mô hình, hệ thống cần tự động kích hoạt một tiến trình tóm tắt nội dung cũ thành một đoạn văn bản ngắn gọn để giữ lại các ý chính quan trọng.
Bộ nhớ dài hạn lại tập trung vào việc lưu trữ các thực thể thông tin bền vững hơn, được trích xuất từ các cuộc trò chuyện và lưu vào cơ sở dữ liệu chuyên dụng. Các thông tin này sẽ được truy xuất và đưa vào phần khởi tạo hệ thống mỗi khi người dùng bắt đầu một phiên làm việc mới.
Sự kết hợp này mang lại trải nghiệm mượt mà, khiến người dùng cảm thấy trợ lý ảo thực sự thấu hiểu họ qua thời gian dài sử dụng mà không gặp phải tình trạng quên mất các thỏa thuận từ các phiên trước.
Xử lý và lưu trữ trạng thái hội thoại
Quản lý trạng thái đòi hỏi cấu trúc dữ liệu chặt chẽ để lưu trữ toàn bộ bối cảnh phiên làm việc bao gồm cả lịch sử trò chuyện và các biến trạng thái trung gian của agent. Dưới đây là đoạn mã mô phỏng cách quản lý và cập nhật lịch sử tin nhắn trong cơ sở dữ liệu.
const { MongoClient } = require('mongodb');

async function saveConversationState(sessionId, newMessages) {
  const uri = process.env.MONGODB_URI;
  const client = new MongoClient(uri);

  try {
    await client.connect();
    const database = client.db('agent_system');
    const collection = database.collection('sessions');

    await collection.updateOne(
      { sessionId: sessionId },
      {
        $push: { messages: { $each: newMessages } },
        $set: { updatedAt: new Date() }
      },
      { upsert: true }
    );
  } catch (error) {
    console.error('Không thể lưu trạng thái phiên làm việc:', error);
    throw error;
  } finally {
    await client.close();
  }
}
Việc duy trì trạng thái hội thoại một cách bền vững giúp hệ thống có thể phục hồi ngay lập tức khi gặp sự cố máy chủ hoặc khi người dùng ngắt kết nối giữa chừng. Cơ chế này đảm bảo tính toàn vẹn dữ liệu cho các tác vụ phức tạp kéo dài qua nhiều bước xử lý.
Kiến trúc phối hợp hệ thống nhiều tác nhân chuyên biệt
Khi các tác vụ trở nên quá phức tạp đối với một thực thể đơn lẻ, việc phân chia công việc cho nhiều chuyên gia ảo phối hợp với nhau là hướng đi tất yếu trong các kiến trúc phần mềm hiện đại. Mô hình này mô phỏng lại cách tổ chức nhân sự trong một doanh nghiệp thực tế, nơi mỗi agent đảm nhận một vai trò chuyên môn riêng biệt và giao tiếp với nhau thông qua một điều phối viên trung tâm.
Một agent chuyên trách có thể tập trung hoàn toàn vào việc viết mã nguồn, trong khi một agent khác chuyên kiểm tra lỗi và một agent thứ ba chịu trách nhiệm tối ưu hóa hiệu năng. Sự phân rã trách nhiệm này giúp tăng độ chính xác tổng thể và giảm thiểu tối đa các lỗi logic do quá tải thông tin.
Việc điều phối luồng dữ liệu giữa các thành phần trong hệ thống nhiều tác nhân đòi hỏi cơ chế định tuyến tin nhắn rõ ràng và các giao thức giao tiếp chuẩn hóa để tránh việc các agent hiểu sai ý định của nhau.
Mô hình điều phối trung tâm và phân chia công việc
Bộ điều phối đóng vai trò là người quản lý dự án, nhận yêu cầu từ người dùng, phân tích các bước cần thực hiện và phân công nhiệm vụ cho các chuyên gia ảo phù hợp. Sau khi nhận kết quả từ từng chuyên gia, bộ điều phối sẽ tổng hợp, kiểm tra tính nhất quán và đưa ra sản phẩm hoàn chỉnh cuối cùng.
Mô hình này đòi hỏi cấu trúc dữ liệu trao đổi giữa các agent phải cực kỳ rõ ràng, bao gồm trạng thái hiện tại, mục tiêu cần đạt được và các ràng buộc cụ thể của từng nhiệm vụ con. Bất kỳ sự mơ hồ nào trong thông điệp trao đổi đều có thể dẫn đến việc agent thực hiện sai lệch hoàn toàn so với yêu cầu ban đầu.
Khả năng mở rộng của kiến trúc này là vô cùng lớn, cho phép đội ngũ phát triển dễ dàng bổ sung thêm các chuyên gia mới vào hệ thống mà không làm ảnh hưởng đến cấu trúc hoạt động của các thành phần hiện hữu.
Triển khai luồng phối hợp đa tác nhân
Đoạn mã dưới đây minh họa cách một bộ điều phối phân chia công việc giữa hai agent chuyên biệt gồm một agent phân tích yêu cầu và một agent viết mã nguồn.
async function orchestrateTask(userGoal) {
  console.log('Bộ điều phối nhận yêu cầu:', userGoal);

  const analystResponse = await runSpecializedAgent('Analyst', 'Phân tích yêu cầu này thành danh sách các bước cụ thể: ' + userGoal);
  console.log('Kết quả phân tích:', analystResponse);

  const developerResponse = await runSpecializedAgent('Developer', 'Dựa trên phân tích sau, hãy viết mã nguồn hoàn chỉnh: ' + analystResponse);
  console.log('Kết quả phát triển:', developerResponse);

  return {
    goal: userGoal,
    analysis: analystResponse,
    implementation: developerResponse
  };
}

async function runSpecializedAgent(role, prompt) {
  const OpenAI = require('openai');
  const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

  const response = await client.chat.completions.create({
    model: 'gpt-4o',
    messages: [
      { role: 'system', content: `Bạn là một chuyên gia trong vai trò: ${role}` },
      { role: 'user', content: prompt }
    ]
  });

  return response.choices[0].message.content;
}
Cách tiếp cận theo mô hình phân tầng chuyên môn giúp hệ thống giải quyết được những bài toán có độ phức tạp cao mà một yêu cầu đơn lẻ không thể xử lý nổi. Việc kiểm soát từng bước trong chuỗi phối hợp giúp đảm bảo chất lượng đầu ra luôn nằm trong tầm kiểm soát của lập trình viên.
Bảo mật hệ thống và chiến lược phòng chống tấn công
Đưa các ứng dụng thông minh vào môi trường vận hành thực tế đi kèm với vô số rủi ro về bảo mật mà các hệ thống phần mềm truyền thống chưa từng phải đối mặt. Các hình thức tấn công mới như thao túng câu lệnh người dùng hoặc lạm dụng quyền hạn của công cụ có thể dẫn đến rò rỉ dữ liệu nhạy cảm hoặc phá hoại hệ thống hạ tầng.
Việc thiết kế các tầng phòng thủ vững chắc từ giai đoạn đầu là yêu cầu bắt buộc đối với mọi kỹ sư phát triển hệ thống. Điều này bao gồm việc kiểm tra chặt chẽ đầu vào, giới hạn quyền hạn thực thi của các công cụ và thiết lập các cơ chế giám sát chi phí API theo thời gian thực.
Sự cẩn trọng trong việc kiểm soát quyền truy cập giúp ngăn chặn kịp thời các hành vi cố ý lợi dụng lỗ hổng từ phía người dùng cuối nhằm ép agent thực hiện các thao tác trái phép.
Ngăn chặn tấn công thao túng câu lệnh
Tấn công thao túng câu lệnh xảy ra khi người dùng cố gắng chèn các chỉ thị độc hại vào dữ liệu đầu vào nhằm đánh lừa agent bỏ qua các quy tắc an toàn đã được thiết lập sẵn trong hệ thống. Để phòng chống hiện tượng này, lập trình viên cần xây dựng các bộ lọc tiền xử lý để phát hiện và vô hiệu hóa các mẫu câu lệnh đáng ngờ trước khi chúng được đưa vào mô hình.
Hệ thống cũng cần áp dụng nguyên tắc đặc quyền tối thiểu cho các công cụ mà agent có quyền sử dụng, đảm bảo rằng ngay cả khi mô hình bị thao túng, nó cũng không thể thực hiện các thao tác nguy hiểm như xóa cơ sở dữ liệu hay truy cập thông tin hệ thống nhạy cảm.
Việc tách biệt rõ ràng giữa dữ liệu do người dùng cung cấp và các chỉ thị hệ thống thông qua cấu trúc thông điệp chuẩn hóa là biện pháp phòng thủ cơ bản nhưng cực kỳ hiệu quả.
Kiểm soát chi phí và giới hạn tài nguyên
Mỗi lần gọi đến các dịch vụ trí tuệ nhân tạo đều tiêu tốn tài nguyên tài chính đáng kể, đặc biệt khi các agent tự động thực hiện các vòng lặp suy luận kéo dài. Do đó, việc thiết lập các giới hạn nghiêm ngặt về số lượng vòng lặp tối đa và tổng số token được phép sử dụng trong mỗi phiên làm việc là bắt buộc.
Hệ thống cần tích hợp các cơ chế theo dõi và cảnh báo tự động khi lượng tiêu thụ tài nguyên vượt quá ngưỡng cho phép, giúp đội ngũ vận hành kịp thời phát hiện các bất thường hoặc các vòng lặp vô hạn do lỗi lập trình.
Việc tối ưu hóa kích thước ngữ cảnh truyền đi trong mỗi yêu cầu cũng góp phần đáng kể trong việc giảm thiểu chi phí vận hành lâu dài cho doanh nghiệp.
Vận hành hệ thống và tối ưu hóa hiệu năng trên môi trường thực tế
Giai đoạn đưa ứng dụng lên môi trường vận hành thực tế đòi hỏi sự chuẩn bị kỹ lưỡng về hạ tầng, công cụ giám sát và quy trình kiểm thử tự động để đảm bảo tính ổn định cao nhất. Các hệ thống thông minh thường có tính phi định tính, nghĩa là cùng một đầu vào nhưng có thể trả về các kết quả khác nhau ở các thời điểm khác nhau, tạo ra thách thức lớn cho công tác kiểm thử phần mềm.
Việc xây dựng hệ thống ghi log chi tiết cho từng bước suy luận của agent giúp kỹ sư nhanh chóng truy vết nguyên nhân khi xảy ra lỗi ngoài ý muốn. Các chỉ số về độ trễ, tỷ lệ thành công của việc gọi công cụ và chi phí token cần được theo dõi liên tục trên các bảng điều khiển trực quan.
Để làm chủ trọn vẹn kỹ năng này và ứng dụng vào dự án thực chiến chuẩn Enterprise, bạn có thể tham khảo khóa học Lập trình AI Agent với NodeJS & OpenAI tại Unicode Academy.

Bình luận 0
Chia sẻ ý kiến hoặc đặt câu hỏi cùng cộng đồng