Bản chất của trạng thái và bộ nhớ trong kiến trúc trí tuệ nhân tạo hiện đại
Hệ thống phần mềm thông minh ngày nay đòi hỏi khả năng duy trì ngữ cảnh xuyên suốt hàng triệu token và nhiều phiên làm việc khác nhau của người dùng. Trạng thái không chỉ đơn thuần là một biến số lưu trữ trong RAM mà còn là tập hợp các vector biểu diễn ngữ nghĩa phức tạp. Việc thiếu hụt một cơ chế quản lý trạng thái đồng bộ sẽ khiến hệ thống mất đi tính liên tục trong các phiên tương tác dài hạn.
Khi xây dựng ứng dụng quy mô lớn, lập trình viên thường đối mặt với thách thức tràn giới hạn token của mô hình ngôn ngữ lớn. Giải pháp truyền thống là cắt ngắn lịch sử trò chuyện theo số lượng tin nhắn cố định nhưng cách làm này vô tình làm mất đi các thông tin quan trọng từ giai đoạn đầu của phiên làm việc. Hệ thống đòi hỏi một giải pháp thông minh hơn để cô đọng và truy xuất thông tin đúng thời điểm cần thiết.
Để giải quyết bài toán này, việc áp dụng mô hình lưu trữ phân tầng kết hợp giữa bộ nhớ đệm tốc độ cao và cơ sở dữ liệu vector là hướng đi tiêu chuẩn trong ngành. Kiến trúc này cho phép hệ thống vừa phản hồi tức thì với các yêu cầu gần nhất vừa có khả năng đào sâu vào kho tri thức khổng lồ được tích lũy qua nhiều tháng vận hành thực tế.
Phân tích giới hạn của bộ nhớ ngắn hạn trong mô hình ngôn ngữ lớn
Mỗi mô hình ngôn ngữ đều có một cửa sổ ngữ cảnh giới hạn tính bằng số lượng token tối đa có thể xử lý trong một lần gọi API. Khi vượt quá giới hạn này, hệ thống sẽ trả về lỗi hoặc tự động loại bỏ các thông tin cũ nhất trong mảng tin nhắn. Hiện tượng này gây ra sự đứt gãy mạch lạc trong các cuộc hội thoại mang tính chất chuyên sâu hoặc khi xử lý các tài liệu kỹ thuật dài.
Việc cố gắng nhồi nhét toàn bộ dữ liệu vào một yêu cầu duy nhất không chỉ đẩy chi phí vận hành API lên mức báo động mà còn làm suy giảm độ chính xác của phản hồi. Mô hình ngôn ngữ lớn thường gặp hiện tượng suy giảm khả năng tập trung khi phải xử lý quá nhiều thông tin không liên quan nằm ở phần giữa của cửa sổ ngữ cảnh.
Do đó, lập trình viên cần thiết kế một tầng trung gian chịu trách nhiệm đánh giá mức độ quan trọng của từng thông điệp. Những thông tin mang tính chất thủ tục tạm thời sẽ được giữ lại trong bộ nhớ ngắn hạn, trong khi các tri thức cốt lõi sẽ được trích xuất và chuyển hóa thành các vector nhúng để lưu trữ dài hạn.
Vai trò cốt lõi của cơ sở dữ liệu vector trong việc duy trì ngữ cảnh
Cơ sở dữ liệu vector đóng vai trò như một bộ não thứ hai giúp hệ thống tìm kiếm thông tin dựa trên sự tương đồng về ngữ nghĩa chứ không phải dựa vào từ khóa chính xác. Khi người dùng đặt câu hỏi, hệ thống sẽ chuyển đổi câu hỏi đó thành một mảng số thực đa chiều và thực hiện phép toán tìm kiếm lân cận gần nhất để trích xuất các tài liệu phù hợp nhất.
Khả năng này cho phép agent tự động gợi nhớ các quyết định đã được đưa ra từ ba tuần trước mà không cần phải tải lại toàn bộ lịch sử trò chuyện vào bộ nhớ RAM của tiến trình Node.js. Hiệu suất xử lý được cải thiện rõ rệt nhờ vào các thuật toán lập chỉ mục tối ưu hóa độ trễ thấp.
Việc lựa chọn công cụ lưu trữ phù hợp phụ thuộc vào quy mô dữ liệu và ngân sách hạ tầng của doanh nghiệp. Các giải pháp mã nguồn mở kết hợp cùng thư viện xử lý bất đồng bộ giúp tối ưu hóa luồng dữ liệu vào ra mà không gây nghẽn cổ chai cho hệ thống.
Xây dựng tầng xử lý vector và lưu trữ phân tầng với Node.js
Việc triển khai tầng lưu trữ vector đòi hỏi sự kết hợp nhịp nhàng giữa các thư viện xử lý mảng số học và các dịch vụ nhúng ngữ nghĩa. Trong môi trường Node.js, việc quản lý bộ nhớ đòi hỏi sự cẩn trọng để tránh hiện tượng rò rỉ bộ nhớ khi xử lý các tập dữ liệu lớn bao gồm hàng nghìn phân đoạn văn bản.
Mã nguồn dưới đây minh họa cách thức khởi tạo một bộ nhớ phân tầng, nơi các tin nhắn đến được chuyển đổi thành vector và lưu trữ an toàn trước khi được tổng hợp lại thành các bản tóm tắt ngắn gọn.
import { OpenAI } from 'openai';

class VectorMemoryEngine {
  constructor(apiKey, vectorDbClient) {
    this.openai = new OpenAI({ apiKey });
    this.db = vectorDbClient;
  }

  async createEmbedding(text) {
    try {
      const response = await this.openai.embeddings.create({
        model: 'text-embedding-3-small',
        input: text,
      });
      return response.data[0].embedding;
    } catch (error) {
      console.error('Loi khi tao embedding:', error.message);
      throw error;
    }
  }

  async saveContext(sessionId, content) {
    const vector = await this.createEmbedding(content);
    await this.db.insert({
      sessionId,
      content,
      vector,
      timestamp: Date.now()
    });
  }
}

module.exports = VectorMemoryEngine;
Đoạn mã trên cung cấp khung nền tảng để giao tiếp với dịch vụ tạo vector của OpenAI thông qua SDK thuần. Việc tách biệt logic gọi API và logic lưu trữ giúp mã nguồn dễ dàng bảo trì và mở rộng khi cần thay đổi nhà cung cấp cơ sở dữ liệu trong tương lai.
Cơ chế bắt lỗi trong phương thức createEmbedding bảo đảm rằng mọi sự cố kết nối mạng hoặc giới hạn tần suất gọi API đều được ghi nhận rõ ràng, từ đó ngăn chặn tình trạng sập tiến trình ngầm của ứng dụng doanh nghiệp.
Tối ưu hóa quá trình tìm kiếm ngữ nghĩa theo thời gian thực
Sau khi dữ liệu đã được số hóa và lưu trữ, bước tiếp theo là xây dựng cơ chế truy vấn thông minh dựa trên độ tương đồng cô-sin. Quá trình này diễn ra ngay khi người dùng gửi một yêu cầu mới vào hệ thống, đòi hỏi thời gian phản hồi tính bằng mili-giây để giữ nguyên trải nghiệm mượt mà.
Hệ thống cần lọc ra các kết quả có độ tương đồng vượt ngưỡng cấu hình trước khi đưa chúng vào prompt truyền cho mô hình ngôn ngữ lớn. Điều này giúp loại bỏ hoàn toàn các thông tin nhiễu có thể làm lệch hướng suy luận của tác nhân tự trị.
Mã nguồn tiếp theo minh họa cách thức thực hiện truy vấn tìm kiếm các phân đoạn ngữ cảnh liên quan nhất từ cơ sở dữ liệu vector.
class ContextRetriever {
  constructor(vectorMemoryEngine, threshold = 0.75) {
    this.engine = vectorMemoryEngine;
    this.threshold = threshold;
  }

  async findRelevantContext(sessionId, query) {
    const queryVector = await this.engine.createEmbedding(query);

    const rawResults = await this.engine.db.query({
      sessionId,
      vector: queryVector,
      topK: 5
    });

    const filteredResults = rawResults.filter(item => item.score >= this.threshold);

    return filteredResults.map(item => item.content).join('\n\n');
  }
}

module.exports = ContextRetriever;
Việc áp dụng bộ lọc ngưỡng điểm số giúp hệ thống chỉ giữ lại các tài liệu có độ liên quan cao nhất, tiết kiệm đáng kể không gian của cửa sổ ngữ cảnh cho các tác vụ suy luận phức tạp tiếp theo.
Cấu trúc này có thể dễ dàng mở rộng để tích hợp sâu hơn vào các lộ trình Backend NodeJS Developer nhằm nâng cao năng lực chuyên môn cho các kỹ sư xây dựng hạ tầng phần mềm thông minh.
Giải pháp xử lý xung đột trạng thái trong môi trường phân tán
Khi các tác nhân thông minh hoạt động đồng thời trong một hệ thống đa luồng, việc tranh chấp quyền ghi trạng thái bộ nhớ rất dễ xảy ra. Nếu không có cơ chế khóa phân tán, dữ liệu lịch sử của người dùng có thể bị ghi đè hoặc mất mát trong quá trình đồng bộ hóa giữa các nút mạng.
Việc sử dụng các công cụ quản lý khóa độc quyền giúp bảo đảm tính toàn vẹn của dữ liệu trong mọi tình huống tải cao. Các kỹ sư cần thiết kế cơ chế thử lại tự động khi gặp xung đột để duy trì tính sẵn sàng cao cho toàn bộ hệ thống.
Mã nguồn dưới đây minh họa cách thức thực hiện cơ chế khóa phân chia trạng thái phiên làm việc trước khi tiến hành cập nhật bộ nhớ dài hạn.
const redis = require('redis');

class DistributedLockManager {
  constructor(redisClient) {
    this.client = redisClient;
  }

  async acquireLock(lockKey, ttlMs = 5000) {
    const identifier = Math.random().toString();
    const result = await this.client.set(lockKey, identifier, {
      PX: ttlMs,
      NX: true
    });
    return result === 'OK' ? identifier : null;
  }

  async releaseLock(lockKey, identifier) {
    const script = `
      if redis.call("get", KEYS[1]) == ARGV[1] then
        return redis.call("del", KEYS[1])
      else
        return 0
      end
    `;
    await this.client.eval(script, { keys: [lockKey], arguments: [identifier] });
  }
}

module.exports = DistributedLockManager;
Thuật toán khóa sử dụng đoạn mã lệnh Lua phía máy chủ Redis giúp bảo đảm việc kiểm tra và xóa khóa diễn ra một cách nguyên tử, tránh tình trạng xóa nhầm khóa của tiến trình khác do độ trễ mạng.
Kỹ thuật này là mảnh ghép không thể thiếu đối với các kiến trúc sư phần mềm khi muốn đảm bảo độ ổn định tuyệt đối cho các hệ thống tự động hóa chạy liên tục trong môi trường sản xuất.
Chiến lược dọn dẹp và nén dữ liệu định kỳ
Dữ liệu vector tích lũy theo thời gian sẽ làm tăng chi phí lưu trữ và làm chậm tốc độ tìm kiếm nếu không có chiến lược bảo trì hợp lý. Hệ thống cần triển khai các tác vụ nền định kỳ để rà soát và gộp nhóm các bản ghi cũ thành các tóm tắt mang tính tổng quan cao.
Quá trình nén dữ liệu giúp giảm số lượng vector cần quét mà vẫn giữ nguyên vẹn các ý chính của toàn bộ phiên làm việc trước đó. Các công việc này thường được thực thi thông qua các hàng đợi bất đồng bộ chạy ngầm trong hệ thống.
Việc áp dụng các kỹ thuật quản lý bộ nhớ thông minh giúp doanh nghiệp tối ưu hóa chi phí vận hành API đồng thời nâng cao trải nghiệm người dùng thông qua những phản hồi nhanh chóng và chính xác.
Kiểm thử và đánh giá hiệu năng hệ thống bộ nhớ phân tầng
Đánh giá hiệu năng của một hệ thống quản lý bộ nhớ phức tạp đòi hỏi các kịch bản kiểm thử tải thực tế nhằm đo lường chính xác độ trễ truy vấn và mức tiêu thụ tài nguyên phần cứng. Các kỹ sư thường sử dụng các công cụ tạo tải giả lập hàng nghìn yêu cầu đồng thời để tìm ra điểm nghẽn của hệ thống.
Việc theo dõi sát sao các chỉ số như thời gian phản hồi trung bình và tỷ lệ lỗi giúp đội ngũ vận hành đưa ra các quyết định mở rộng hạ tầng kịp thời trước khi hệ thống chịu áp lực lớn từ phía người dùng.
Phân tích đánh đổi giữa tốc độ truy xuất và độ chính xác ngữ nghĩa
Mỗi quyết định thiết kế kiến trúc đều đi kèm với những sự đánh đổi nhất định. Việc sử dụng các chỉ mục tìm kiếm xấp xỉ giúp tăng tốc độ truy vấn lên hàng trăm lần nhưng lại làm giảm nhẹ độ chính xác so với phương pháp quét toàn bộ không gian vector.
Tùy thuộc vào yêu cầu nghiệp vụ cụ thể của từng sản phẩm, đội ngũ phát triển có thể cân đối giữa độ chính xác tuyệt đối và thời gian phản hồi tối ưu để mang lại giá trị tốt nhất cho người dùng cuối.
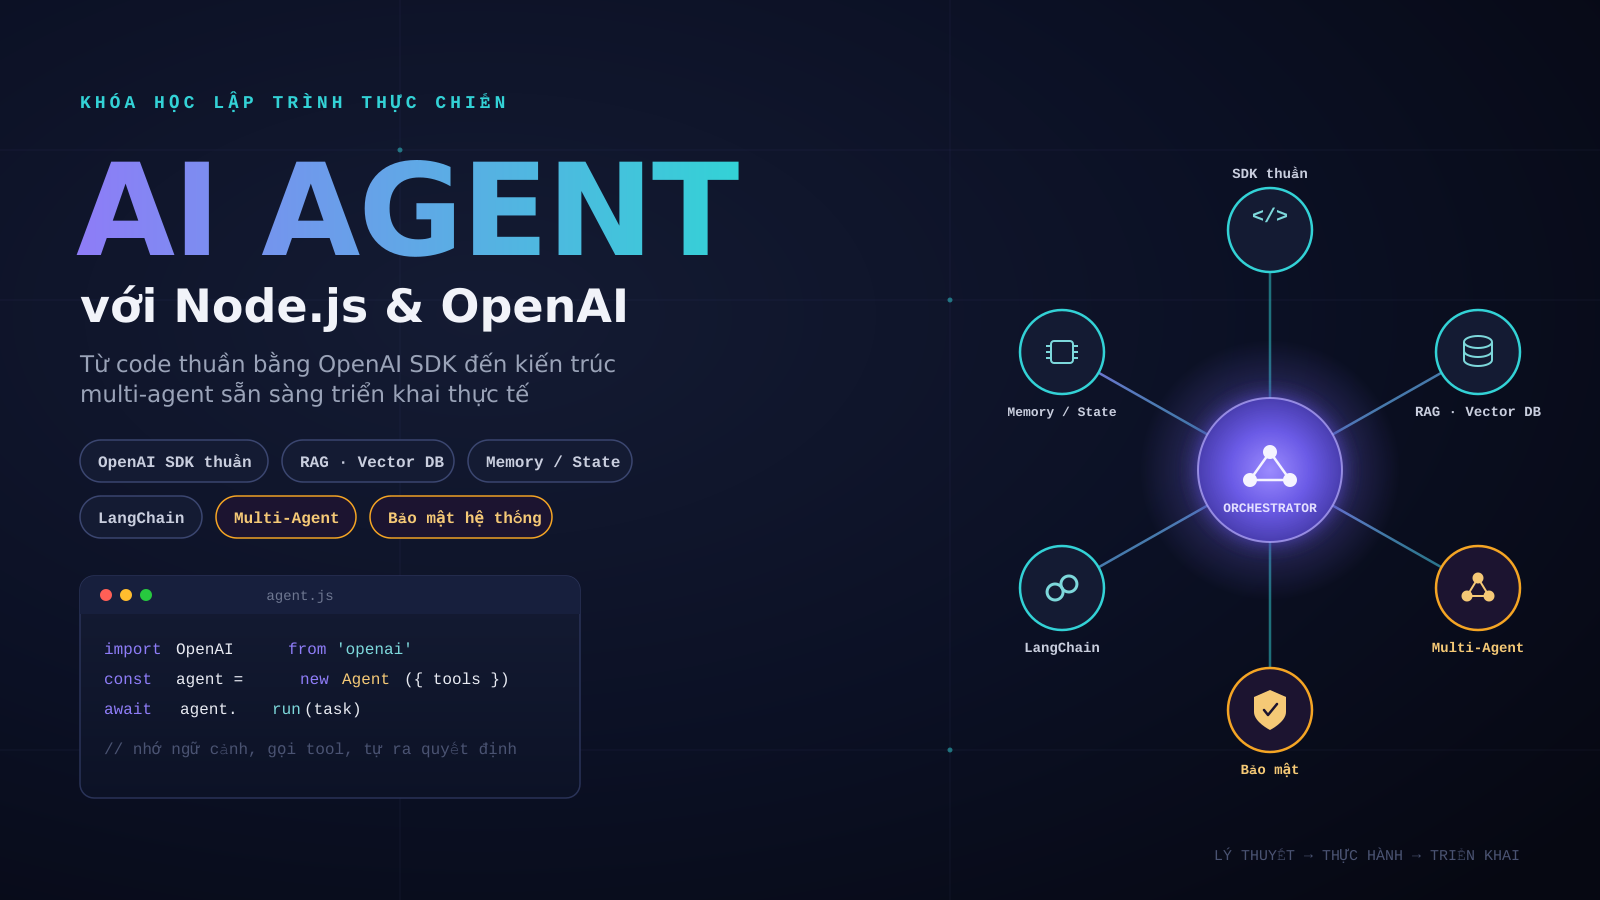
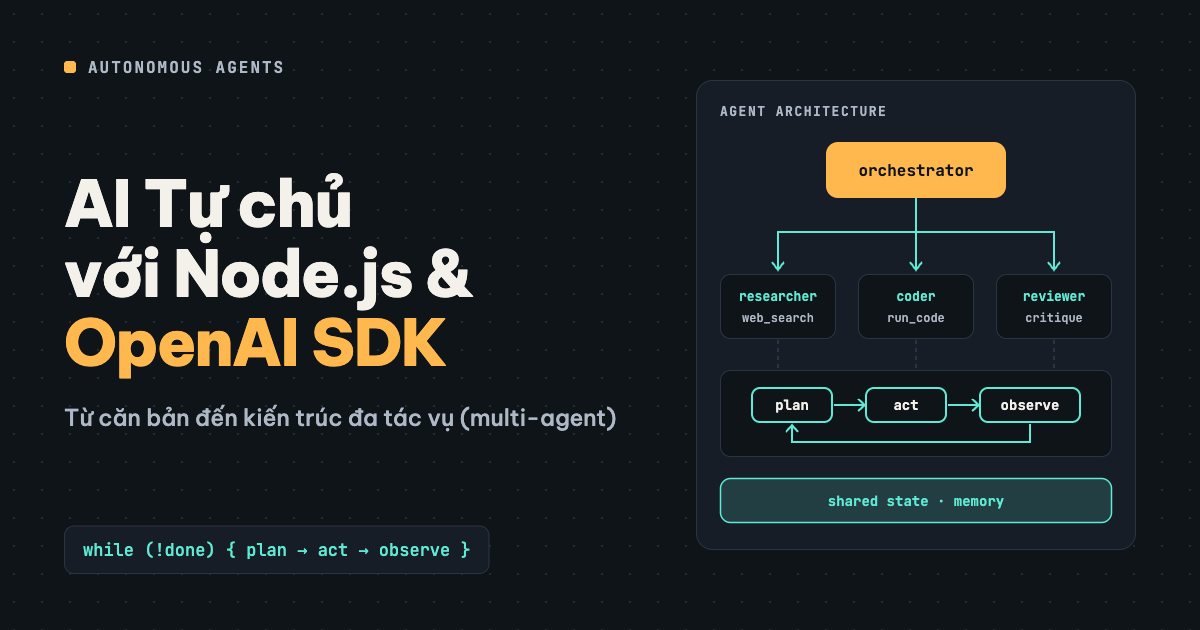
Những kiến thức chuyên sâu này đóng vai trò nền tảng giúp các kỹ sư tự tin thiết kế những hệ thống phần mềm thông minh quy mô lớn. Nếu bạn muốn làm chủ trọn vẹn kiến thức này và xây dựng ứng dụng thực tế, hãy tham khảo khóa học Lập trình AI Agent với NodeJS & OpenAI tại Unicode Academy.


Bình luận 0
Chia sẻ ý kiến hoặc đặt câu hỏi cùng cộng đồng