- Giải mã bài toán hiệu năng và kiến trúc dữ liệu trong Headless CMS
- Xây dựng chiến lược phân tách dữ liệu và quản lý trạng thái
- Triển khai giải pháp bảo mật và kiểm soát truy cập nâng cao
- Tối ưu hóa hiệu năng và chiến lược vận hành trên môi trường Production
- Xây dựng tiêu chuẩn phát triển và quy trình bàn giao sản phẩm chuyên nghiệp
Giải mã bài toán hiệu năng và kiến trúc dữ liệu trong Headless CMS
Thách thức về tốc độ truy vấn khi dự án mở rộng quy mô lớn
Trong các hệ thống phần mềm hiện đại, việc tách biệt hoàn toàn tầng hiển thị và tầng quản lý nội dung đòi hỏi một tư duy thiết kế hoàn toàn mới. Khi lượng bản ghi tăng lên hàng triệu dòng, cơ sở dữ liệu bắt đầu chịu áp lực nặng nề từ các câu lệnh truy vấn phức tạp kết hợp với các mối quan hệ liên kết nhiều tầng. Nếu không có chiến lược phân tách tài nguyên và lập chỉ mục hợp lý, thời gian phản hồi từ máy chủ sẽ tăng phi mã, trực tiếp làm suy giảm trải nghiệm người dùng trên các giao diện frontend hiện đại.
Các kiến trúc sư phần mềm thường phải đối mặt với bài toán nghẽn cổ chai tại tầng giao tiếp mạng và cơ chế phân giải dữ liệu động. Việc lạm dụng các mối quan hệ liên kết dữ liệu mà không cân nhắc đến hệ quả lưu trữ sẽ dẫn đến việc tiêu tốn bộ nhớ nghiêm trọng trên tiến trình xử lý. Do đó, việc hiểu rõ bản chất luồng hoạt động bên dưới của hệ thống quản lý nội dung là bước đệm cốt lõi để xây dựng một nền tảng vận hành ổn định và bền vững trước mọi biến động về tải.
Bên cạnh đó, chiến lược tối ưu hóa cấu trúc dữ liệu không chỉ dừng lại ở việc tinh chỉnh các câu lệnh truy vấn mà còn mở rộng ra cách tổ chức các mô hình dữ liệu sao cho phù hợp với đặc thù nghiệp vụ doanh nghiệp. Khi triển khai các dự án thương mại điện tử hoặc cổng thông tin điện tử lớn, việc áp dụng Xây dựng hệ thống vững chắc là chìa khóa giúp đội ngũ phát triển kiểm soát toàn bộ vòng đời của dữ liệu mà không sợ gặp sự cố tràn bộ nhớ bất ngờ.
Tư duy thiết kế schema tối ưu cho hệ thống phân tán
Việc định nghĩa các trường dữ liệu và các mối quan hệ giữa chúng quyết định trực tiếp đến hiệu năng đọc ghi của toàn bộ ứng dụng. Một thiết kế schema tồi sẽ tạo ra vô số các truy vấn dư thừa mỗi khi hệ thống cần tổng hợp thông tin để trả về cho máy khách. Do đó, việc áp dụng các nguyên tắc chuẩn hóa dữ liệu kết hợp với việc phi chuẩn hóa có chọn lọc sẽ giúp cân bằng giữa tính toàn vẹn và tốc độ phản hồi của hệ thống.
Trong các hệ thống quản lý nội dung mã nguồn mở, việc cấu hình các mối quan hệ đa chiều đòi hỏi sự cẩn trọng tuyệt đối để tránh tình trạng vòng lặp tham chiếu hoặc tải dư thừa các trường dữ liệu không cần thiết. Các lập trình viên cần chủ động cấu hình các tham số giới hạn trường trả về ngay từ tầng giao tiếp API để giảm thiểu dung lượng gói tin truyền tải qua mạng. Điều này không chỉ tiết kiệm băng thông mà còn giúp các ứng dụng tiêu thụ tài nguyên một cách tối ưu nhất.
Để đạt được hiệu quả cao nhất trong quá trình vận hành, các kỹ sư cần xây dựng sẵn một lộ trình Backend NodeJS Developer toàn diện để nắm vững các kỹ thuật quản lý bộ nhớ đệm và xử lý bất đồng bộ. Việc nắm bắt các nguyên lý cốt lõi này sẽ giúp đội ngũ tự tin giải quyết các bài toán tải cao mà không bị phụ thuộc vào các công cụ bên ngoài.
Xây dựng chiến lược phân tách dữ liệu và quản lý trạng thái
Ứng dụng mô hình phân lớp trong xử lý nghiệp vụ backend
Việc gom toàn bộ logic nghiệp vụ vào cùng một nơi sẽ nhanh chóng biến mã nguồn thành một khối hỗn độn khó bảo trì khi dự án bước vào giai đoạn phát triển mở rộng. Mô hình phân lớp giúp chia tách rõ ràng trách nhiệm giữa tầng nhận yêu cầu, tầng xử lý logic nghiệp vụ và tầng giao tiếp cơ sở dữ liệu. Nhờ đó, mỗi thành phần trong hệ thống có thể được kiểm thử độc lập và dễ dàng thay thế khi có yêu cầu thay đổi công nghệ.
Khi các thành phần được phân rã rạch ròi, việc tìm kiếm nguyên nhân gốc rễ của lỗi trở nên đơn giản hơn rất nhiều đối với đội ngũ phát triển. Các hàm xử lý nghiệp vụ tập trung vào việc tính toán và chuyển đổi dữ liệu mà không bị ảnh hưởng bởi các chi tiết liên quan đến giao thức truyền thông hay cách thức lưu trữ vật lý. Điều này tạo ra một bộ khung mã nguồn sạch sẽ, dễ đọc và tuân thủ tuyệt đối các nguyên lý thiết kế phần mềm hiện đại.
Việc duy trì một cấu trúc thư mục chuẩn mực cùng với các quy ước đặt tên rõ ràng sẽ tạo đà phát triển mạnh mẽ cho các dự án phần mềm có quy mô lớn. Sự minh bạch trong cách phân chia các module chức năng chính là nền tảng để xây dựng những hệ thống có khả năng mở rộng hàng ngang cực kỳ mạnh mẽ trong tương lai.
Tối ưu hóa luồng dữ liệu bất đồng bộ với cơ chế hàng đợi
Trong các kịch bản thực tế, có rất nhiều tác vụ nặng như gửi email hàng loạt, xử lý hình ảnh độ phân giải cao hoặc đồng bộ dữ liệu với bên thứ ba không nên được thực thi trực tiếp trong luồng xử lý yêu cầu của người dùng. Việc ép máy chủ chờ đợi các tác vụ này hoàn thành sẽ làm tê liệt toàn bộ hệ thống và gây ra hiện tượng từ chối dịch vụ do cạn kiệt kết nối. Giải pháp tối ưu là đưa các tác vụ này vào các hàng đợi xử lý ngầm độc lập.
Việc ứng dụng cơ chế hàng đợi giúp phân bổ đều tải trọng của hệ thống theo thời gian thay vì dồn dập vào những khung giờ cao điểm. Các tiến trình worker sẽ âm thầm lấy các công việc từ hàng đợi và xử lý lần lượt theo mức độ ưu tiên đã được định nghĩa sẵn. Nếu một tiến trình gặp sự cố bất ngờ, cơ chế thử lại tự động sẽ đảm bảo không có dữ liệu nào bị mất mát trong suốt quá trình vận hành.
Khối mã nguồn dưới đây minh họa cách thức cấu hình một tiến trình xử lý bất đồng bộ an toàn bằng JavaScript để xử lý các tác vụ nền mà không làm gián đoạn luồng phản hồi chính:
const { Queue, Worker } = require('bullmq');
const Redis = require('ioredis');

const connection = new Redis({
  host: '127.0.0.1',
  port: 6379,
  maxRetriesPerRequest: null
});

const dataProcessingQueue = new Queue('data-processing', { connection });

async function addJobToQueue(payload) {
  try {
    await dataProcessingQueue.add('process-content', payload, {
      attempts: 3,
      backoff: {
        type: 'exponential',
        delay: 1000
      },
      removeOnComplete: true
    });
    console.log('Cong việc da duoc đưa vao hang đợi thanh cong');
  } catch (error) {
    console.error('Loi khi them cong việc vao hang đợi:', error.message);
  }
}

module.exports = { addJobToQueue };
Đoạn mã trên sử dụng thư viện quản lý hàng đợi mạnh mẽ kết hợp với dịch vụ lưu trữ trong bộ nhớ để đảm bảo tính sẵn sàng cao cho các tác vụ nền. Việc cấu hình số lần thử lại cùng chiến lược giãn cách thời gian giúp hệ thống tự động phục hồi sau các sự cố mất kết nối ngắn hạn với cơ sở dữ liệu hoặc dịch vụ bên ngoài.
Triển khai giải pháp bảo mật và kiểm soát truy cập nâng cao
Thiết chế tầng bảo vệ dữ liệu với cơ chế phân quyền chi tiết
Bảo mật không bao giờ là một tính năng được bổ sung vào phút chót mà phải là một phần cốt lõi được thiết kế ngay từ những ngày đầu khởi động dự án. Trong các hệ thống quản lý nội dung hiện đại, việc phân quyền truy cập không chỉ dừng lại ở việc xác định người dùng đã đăng nhập hay chưa mà còn phải kiểm soát chi tiết đến từng hành động trên từng tài nguyên cụ thể. Mỗi yêu cầu gửi lên máy chủ đều phải trải qua các bước kiểm tra tính hợp lệ của định danh và quyền hạn tương ứng.
Việc áp dụng mô hình phân quyền dựa trên vai trò kết hợp với quyền hạn chi tiết giúp ngăn chặn triệt để các hành vi truy cập trái phép vào các vùng dữ liệu nhạy cảm của doanh nghiệp. Các nhà phát triển cần thiết lập các tầng kiểm tra trung gian để chặn đứng ngay lập tức các yêu cầu thiếu thông tin xác thực trước khi chúng kịp chạm tới tầng xử lý nghiệp vụ chính. Điều này giúp giảm tải đáng kể cho máy chủ và bảo vệ hệ thống trước các cuộc tấn công dò quét tự động.
Bên cạnh đó, việc mã hóa các thông tin nhạy cảm trước khi lưu xuống cơ sở dữ liệu là tiêu chuẩn bắt buộc trong mọi hệ thống đạt chuẩn doanh nghiệp. Sự cẩn trọng trong từng khâu xử lý dữ liệu sẽ giúp doanh nghiệp tránh khỏi những rủi ro pháp lý và tổn thất uy tín nghiêm trọng do rò rỉ thông tin người dùng.
Kiểm soát luồng dữ liệu đầu vào và ngăn chặn lỗ hổng bảo mật
Hầu hết các lỗ hổng bảo mật nghiêm trọng trong các ứng dụng web đều xuất phát từ việc tin tưởng mù quáng vào dữ liệu do người dùng hoặc các hệ thống bên ngoài gửi đến. Mọi dữ liệu đầu vào từ biểu mẫu, tham số đường dẫn hay tệp tin tải lên đều phải được kiểm tra, làm sạch và ép kiểu một cách ngặt nghèo trước khi đưa vào xử lý. Việc thiết lập các quy tắc kiểm tra nghiêm ngặt sẽ loại bỏ ngay từ đầu các đoạn mã độc hại có ý địnhâm nhập vào hệ thống.
Việc sử dụng các thư viện kiểm tra dữ liệu chuyên dụng giúp đơn giản hóa quá trình định nghĩa các quy tắc hợp lệ cho từng trường thông tin cụ thể. Thay vì viết các câu lệnh kiểm tra thủ công dễ bỏ sót, các lập trình viên có thể tận dụng các lược đồ định nghĩa sẵn để tự động từ chối mọi yêu cầu không đạt chuẩn ngay tại tầng cổng vào. Điều này duy trì sự sạch sẽ và an toàn cho toàn bộ luồng dữ liệu luân chuyển bên trong ứng dụng.
Khối mã nguồn dưới đây minh họa cách thức kiểm tra và làm sạch dữ liệu đầu vào an toàn trước khi lưu trữ vào cơ sở dữ liệu:
const Joi = require('joi');

const contentSchema = Joi.object({
  title: Joi.string().min(5).max(255).required(),
  slug: Joi.string().pattern(/^[a-z0-9-]+$/).required(),
  body: Joi.string().required(),
  status: Joi.string().valid('draft', 'published', 'archived').default('draft')
});

async function validateIncomingData(req, res, next) {
  try {
    const validationResult = await contentSchema.validateAsync(req.body, {
      abortEarly: false,
      stripUnknown: true
    });
    req.validatedData = validationResult;
    next();
  } catch (error) {
    const errorMessages = error.details.map(detail => detail.message);
    res.status(400).json({
      success: false,
      message: 'Du lieu dau vao khong hop le',
      errors: errorMessages
    });
  }
}

module.exports = { validateIncomingData };
Đoạn mã trên thể hiện cách thức áp dụng lược đồ kiểm tra dữ liệu chặt chẽ để loại bỏ các trường thông tin không mong muốn và đảm bảo mọi thuộc tính đều tuân thủ đúng định dạng nghiệp vụ. Việc sử dụng cấu hình này giúp bảo vệ cơ sở dữ liệu khỏi các dữ liệu rác và ngăn chặn các dạng tấn công chèn mã độc hại.
Tối ưu hóa hiệu năng và chiến lược vận hành trên môi trường Production
Chiến lược lưu đệm dữ liệu thông minh trong hệ thống phân tán
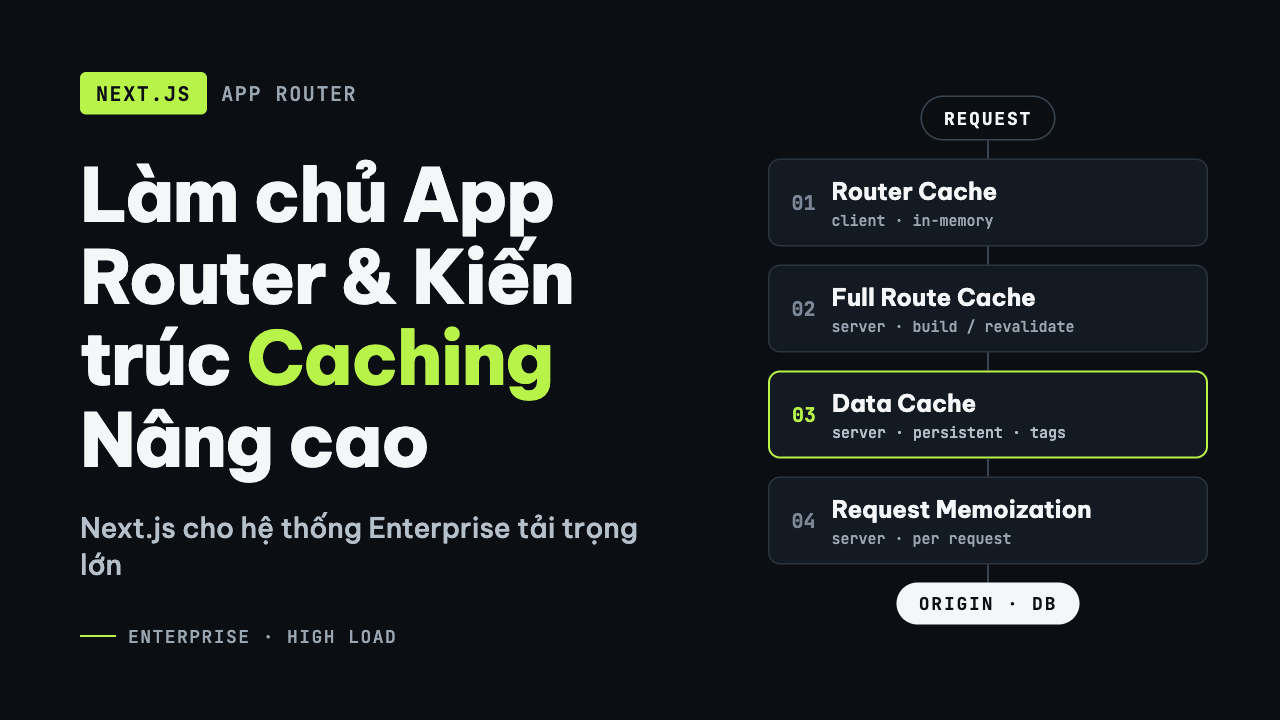
Khi lượng truy cập tăng vọt, việc truy vấn trực tiếp cơ sở dữ liệu cho mọi yêu cầu đọc thông tin sẽ nhanh chóng làm sập hệ thống do quá tải tài nguyên phần cứng. Giải pháp duy nhất để duy trì tốc độ phản hồi tính bằng mili-giây là xây dựng một tầng lưu đệm dữ liệu thông minh nằm giữa máy chủ ứng dụng và cơ sở dữ liệu. Dữ liệu tĩnh hoặc ít thay đổi sẽ được lưu trữ tạm thời trong bộ nhớ tốc độ cao để phục vụ trực tiếp cho các yêu cầu tiếp theo mà không cần chạm tới tầng lưu trữ chính.
Tuy nhiên, bài toán khó nhất trong việc áp dụng bộ nhớ đệm chính là cơ chế làm sạch dữ liệu cũ khi nội dung gốc có sự thay đổi. Các kỹ sư cần thiết lập các sự kiện lắng nghe để tự động vô hiệu hóa các phân vùng lưu đệm liên quan ngay khi có thao tác chỉnh sửa nội dung từ phía người quản trị. Điều này đảm bảo người dùng cuối luôn nhận được thông tin mới nhất mà không gặp phải tình trạng lệch pha dữ liệu.
Việc kết hợp chiến lược lưu đệm đa tầng cùng với các cơ chế định danh tài nguyên thông minh sẽ giúp giảm tải đến tám mươi phần trăm số lượng câu lệnh truy vấn xuống cơ sở dữ liệu trong giờ cao điểm. Đây là kỹ thuật sống còn mà mọi kiến trúc sư hệ thống đều phải thành thạo khi xây dựng các ứng dụng phục vụ lượng lớn người dùng đồng thời.
Giám sát và đo lường hiệu năng hệ thống theo thời gian thực
Việc đưa một ứng dụng lên môi trường vận hành chính thức không có nghĩa là công việc của đội ngũ phát triển đã hoàn tất mà đó mới chỉ là khởi đầu của giai đoạn theo dõi và tinh chỉnh liên tục. Các chỉ số về mức độ sử dụng bộ nhớ, thời gian phản hồi trung bình của từng điểm cuối giao tiếp và tỷ lệ lỗi phát sinh cần phải được thu thập liên tục và trực quan hóa trên các bảng điều khiển trung tâm. Nhờ đó, các kỹ sư có thể phát hiện sớm các dấu hiệu quá tải hoặc rò rỉ bộ nhớ trước khi chúng kịp gây ra ảnh hưởng tiêu cực đến người dùng cuối.
Việc thiết lập các ngưỡng cảnh báo tự động qua các kênh liên lạc nội bộ giúp đội ngũ vận hành phản ứng tức thì với các sự cố bất ngờ xảy ra vào giữa đêm. Mọi thông tin chi tiết về lỗi cùng với dấu vết ngăn xếp thực thi phải được ghi lại đầy đủ trong các tệp nhật ký hệ thống để phục vụ cho công tác phân tích nguyên nhân gốc rễ sau đó. Sự minh bạch trong khâu giám sát chính là yếu tố phân định ranh giới giữa một hệ thống chuyên nghiệp và một sản phẩm thiếu đầu tư.
Đoạn mã dưới đây minh họa cách thức tích hợp công cụ đo lường thời gian phản hồi yêu cầu vào ứng dụng Node.js để kiểm soát chất lượng dịch vụ theo thời gian thực:
const responseTime = require('response-time');

function setupPerformanceMonitoring(app) {
  app.use(responseTime((req, res, time) => {
    const logData = {
      method: req.method,
      url: req.originalUrl,
      status: res.statusCode,
      duration: `${time.toFixed(2)}ms`,
      timestamp: new Date().toISOString()
    };

    if (time > 500) {
      console.warn('Canh bao: Yeu cau phan hoi qua cham:', JSON.stringify(logData));
    } else {
      console.log('Thong tin thuc thi:', JSON.stringify(logData));
    }
  }));
}

module.exports = { setupPerformanceMonitoring };
Đoạn mã trên sử dụng một hàm trung gian để đo lường chính xác thời gian xử lý của từng yêu cầu HTTP đi qua hệ thống ứng dụng. Những yêu cầu vượt quá ngưỡng thời gian cho phép sẽ tự động được ghi nhận dưới mức độ cảnh báo, giúp đội ngũ kỹ thuật dễ dàng khoanh vùng các điểm nghẽn hiệu năng trong mã nguồn.
Xây dựng tiêu chuẩn phát triển và quy trình bàn giao sản phẩm chuyên nghiệp
Tự động hóa quy trình kiểm thử và bàn giao mã nguồn
Việc phụ thuộc vào các thao tác thủ công khi đưa mã nguồn lên môi trường vận hành chính thức tiềm ẩn rất nhiều rủi ro về con người và dễ dẫn đến những sai sót không đáng có. Một quy trình bàn giao sản phẩm chuyên nghiệp đòi hỏi mọi thay đổi mã nguồn đều phải vượt qua các bài kiểm thử tự động về tính đúng đắn và bảo mật trước khi được phép hòa nhập vào nhánh chính. Sự tự động hóa này giúp tiết kiệm hàng giờ đồng hồ làm việc thủ công và đảm bảo tính nhất quán tuyệt đối giữa các môi trường phát triển.
Các công cụ tích hợp liên tục sẽ tự động kích hoạt các tập lệnh kiểm thử mỗi khi có một yêu cầu hợp nhất mã nguồn mới được tạo ra trên hệ thống quản lý phiên bản. Nếu bất kỳ bài kiểm thử nào thất bại, quá trình bàn giao sẽ ngay lập tức bị dừng lại và thông báo chi tiết sẽ được gửi về cho lập trình viên phụ trách. Điều này tạo ra một văn hóa làm việc kỷ luật và đề cao chất lượng sản phẩm trong toàn bộ tập thể kỹ thuật.
Bên cạnh đó, việc đóng gói ứng dụng thành các container độc lập giúp loại bỏ hoàn toàn hiện tượng mã nguồn chạy tốt trên máy cá nhân nhưng lại phát sinh lỗi khi đưa lên máy chủ. Mọi tệp cấu hình môi trường và thư viện phụ thuộc đều được đóng gói gọn gàng bên trong các hình ảnh container chuẩn hóa, sẵn sàng triển khai trên bất kỳ hạ tầng điện toán đám mây nào.
Tối ưu hóa trải nghiệm người dùng thông qua kiến trúc API chuẩn mực
Sự thành công của một ứng dụng hiện đại không chỉ phụ thuộc vào chất lượng của phần cứng máy chủ mà còn được quyết định bởi cách mà hệ thống giao tiếp với các tầng hiển thị bên ngoài. Việc thiết kế một giao diện lập trình ứng dụng rõ ràng, nhất quán và tuân thủ các chuẩn mực quốc tế giúp đội ngũ phát triển giao diện người dùng dễ dàng tích hợp mà không gặp phải bất kỳ rào cản kỹ thuật nào. Mọi phản hồi từ máy chủ phải có cấu trúc tường minh, cung cấp đầy đủ thông tin trạng thái và mã lỗi chuẩn xác để phía máy khách có thể xử lý mượt mà mọi tình huống.
Việc tối ưu hóa dung lượng gói tin truyền tải và áp dụng các chiến lược nén dữ liệu mạng sẽ giúp giảm thiểu tối đa độ trễ cho các thiết bị di động có đường truyền internet hạn chế. Sự chăm chút tỉ mỉ từ những chi tiết nhỏ nhất trong thiết kế API chính là điểm khác biệt tạo nên đẳng cấp của một kỹ sư phần mềm thực thụ. Qua việc nắm vững toàn bộ các kỹ thuật thiết kế, bảo mật và tối ưu hóa hệ thống backend, bạn sẽ hoàn toàn tự tin đảm nhận các dự án phần mềm có quy mô lớn và độ phức tạp cao.
Nếu bạn muốn làm chủ trọn vẹn kiến thức này và xây dựng ứng dụng thực tế, hãy tham khảo khóa học Xây dựng Back-End Nodejs bằng Strapi CMS tại Unicode Academy.


Bình luận 0
Chia sẻ ý kiến hoặc đặt câu hỏi cùng cộng đồng